Podmíněná pravděpodobnost a Bayesův vzorec
Interaktivní model podmíněné pravděpodobnosti, přirozených četností a Bayesova pravidla
Interaktivní kalkulátor a vizualizace podmíněné pravděpodobnosti a Bayesova vzorce. Ukazuje vztah mezi apriorní pravděpodobností (prevalencí jevu v populaci), senzitivitou a specificitou diagnostického testu a výslednou aposteriorní pravděpodobností.
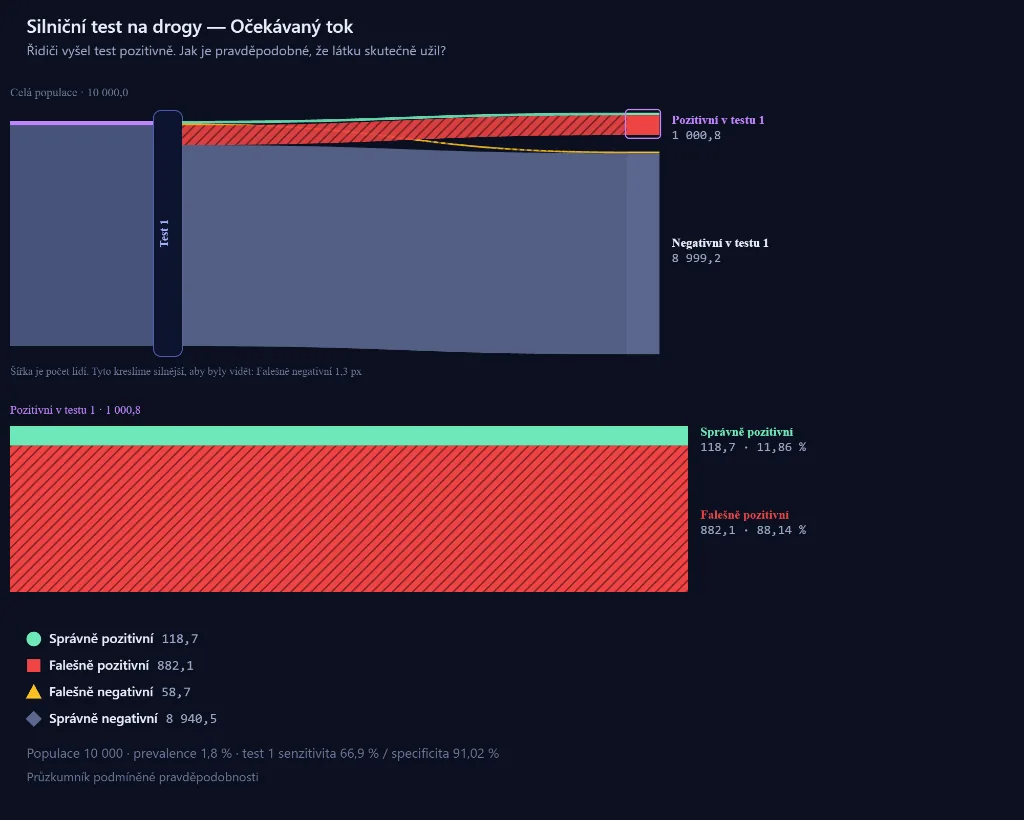
Vizualizace podmíněné pravděpodobnosti pomocí stromu přirozených četností a kontingenční tabulky
O projektu a kontext
Aplikace slouží k výuce pravděpodobnosti a statistiky. Zaměřuje se na typický kognitivní omyl (klam základní míry / base-rate fallacy), kdy lidé přeceňují spolehlivost pozitivního výsledku testu při nízké prevalenci onemocnění v populaci. Nástroj převádí abstraktní pravděpodobnosti na přirozené četnosti (např. počet osob z 1 000 nebo 10 000), které jsou pro lidské uvažování srozumitelnější.
Klíčové funkce a schopnosti
Přirozené četnosti a matice populace
Zobrazení reprezentativního vzorku populace (1 000 až 100 000 jedinců) s barevným rozlišením pravdivě a falešně pozitivních případů.
Frekvenční strom
Rozvětvení populace na nemocné a zdravé a následně na pozitivně a negativně testované s přesnými počty osob v každé větvi.
Kontingenční tabulka 2x2
Přehledné uspořádání dat do tabulky s výpočtem pozitivní a negativní prediktivní hodnoty (PPV a NPV).
Dvoustupňové testování
Modelování opakovaného konfirmačního testu a sledování růstu aposteriorní pravděpodobnosti po druhém nezávislém testu.
Praktické scénáře
Přednastavené příklady z medicíny, kriminalistiky a kontroly kvality (mamografický screening, test na vzácnou nemoc, spolehlivost bezpečnostních senzorů).
Výukové využití a pedagogický přínos
Studenti i odborníci často chybují v interpretaci podmíněných pravděpodobností: zaměňují pravděpodobnost pozitivního testu u nemocného P(+|D) s pravděpodobností nemoci u pozitivně testovaného P(D|+). Model ukazuje, jak se při prevalenci 0,1 % i při 99% spolehlivosti testu většina pozitivních výsledků ukáže jako falešná.